如何用 OCR 让扫描版 PDF 变得可搜索
更新于 14/10/2026
在 PDF 里按 Ctrl+F 却什么也搜不到?这份文档很可能是扫描件:每一页都只是一张图片,没有可以搜索或复制的文字。光学字符识别(OCR)会读出每页上的文字,从而解决这个问题。
怎么判断 PDF 是不是扫描件?
试着用鼠标选中一句话,或者用 Ctrl+F(Mac 上为 Cmd+F)搜索一个词。如果明明能看到这个词,却什么也选不中、什么也搜不到,说明这一页是图片。
扫描仪扫出来的文档,以及由照片转换成的 PDF,都属于这种情况。
4 步让 PDF 变得可搜索
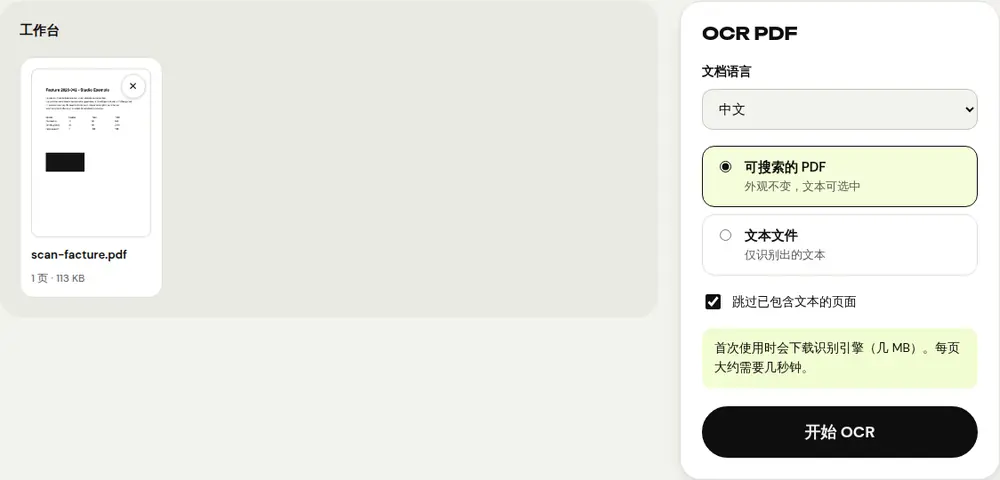
- 打开“OCR PDF”工具,选择您的扫描版 PDF。
- 在“文档语言”中选择文字所用的语言。“法语 + 英语”适合两种语言混排的文档。
- 选择输出结果:“可搜索的 PDF”保持原有外观,同时文字可以选中;“文本文件”则只输出识别出的文字,按页排列,保存为 .txt 文件。
- 点击“开始 OCR”,然后下载文件。文件名以“_ocr”结尾。
选择“可搜索的 PDF”时,页面图像保持不变:识别出的文字以不可见的方式放在每一行下方,可以直接搜索或复制。
如何获得更好的识别效果
- 使用清晰、对比度高的扫描件:模糊或颜色太浅的文字很难识别准确。
- 开始 OCR 之前,先用“旋转 PDF”把倒置的页面转正。
- 选对语言:这能明显提高带重音字母的识别准确率。
- 保持勾选“跳过已包含文本的页面”:在混合文档中,只会处理扫描页面。
- 重要的数字和专有名词请再核对一遍:OCR 可能会出错,而且它是为印刷文字设计的,不适合手写文字。
如果没有识别到任何文字,PDFRoll 会提示您:这时请检查所选语言和扫描质量。
OCR 之前和之后
原始材料是用手机拍的照片?先用“扫描为 PDF”,它会把背景变白、让文字更清晰,然后再把得到的 PDF 交给“OCR PDF”处理。
扫描件通常体积较大。如果需要减小文件,请在 OCR 之前压缩,最好使用“推荐压缩”:在 OCR 之后压缩,可能会把页面重新变成图片,抹掉识别出的文字;而 OCR 之前压缩过度,字符会变得不够清晰,识别效果也会变差。文字识别完成后,可以用“PDF 转 Word”在可编辑的文档中继续修改。
隐私安全吗?
文字识别由您的浏览器完成。首次使用时会下载识别引擎(几 MB),但您的文档始终不会离开您的设备。之后每页大约需要几秒钟,具体取决于设备性能。
常见问题
OCR 会改变 PDF 的外观吗?
不会。选择“可搜索的 PDF”时,页面保持原样:识别出的文字以不可见的方式添加进去,方便选中和搜索。
支持识别哪些语言?
法语、英语、西班牙语、德语、意大利语、葡萄牙语、荷兰语、中文、日语和印地语,另外还有适用于双语文档的“法语 + 英语”。
可以对照片做 OCR 吗?
可以。先用“扫描为 PDF”把照片转换成 PDF,再把这个 PDF 交给“OCR PDF”处理。
更多指南
- 如何压缩 PDF 大小,方便通过邮件发送
- 如何在手机上签署 PDF
- 如何把多张照片合成一个 PDF
- 如何免费编辑 PDF,无需 Acrobat
- 如何把多个 PDF 合并成一个文件
- 如何给 PDF 设置密码保护
- 如何把 PDF 转换成 Excel,不用重新录入数字
- 如何翻译 PDF
- 如何真正涂黑 PDF
- 如何把 PowerPoint 转换成 PDF 再发送
- 如何拆分 PDF 页面
- 如何将 PDF 转换为可编辑的 Word 文档
- 如何将 Word 文档转换为 PDF
- 如何无需打印直接填写 PDF 表单
- 如何把 PDF 压缩到大小上限以内
- 如何旋转 PDF 并永久保存旋转结果
- 如何把 PDF 转换成 JPG 图片
- 如何给 PDF 添加页码
- 如何给 PDF 添加水印
- 免费的 Smallpdf 替代工具:客观对比
- 免费的 iLovePDF 替代工具:客观对比
- Adobe Acrobat 在线版的免费替代工具